問い合わせをAIで「料金」「不具合」「その他」に振り分けたい。何件か試したら、それらしい答えが返ってきた。それでも導入を決めにくいのは、何をもって正解とするかが、まだ曖昧だからかもしれません。
最初に作るのは、入力と正解だけでなく「迷ったら誰へ戻すか」を含む評価表です。この記事は架空の問い合わせを使う設計例です。AIモデル間のランキングや、実測の正解率を示すものではありません。
分類名より先に、行き先を決める
分類は、その後の仕事とつながって初めて役に立ちます。「料金」と「契約」を分けても対応担当が同じなら、最初はまとめる選択もできます。逆に、緊急障害を通常の質問へ送る誤りは、軽い分類間違いとして扱えません。
| 分類 | 含める例 | 判断を戻す例 |
|---|---|---|
| 利用方法 | 画面の使い方、設定場所 | 利用者を特定できない |
| 契約・料金 | プランの質問、見積もり相談 | 個別契約の判断が必要 |
| 不具合 | 操作が進まない、エラー | 複数の問題が1件に混ざる |
| 判断保留 | 根拠不足、対象外、曖昧 | 担当者が原文を確認する |
普通の例だけを集めない
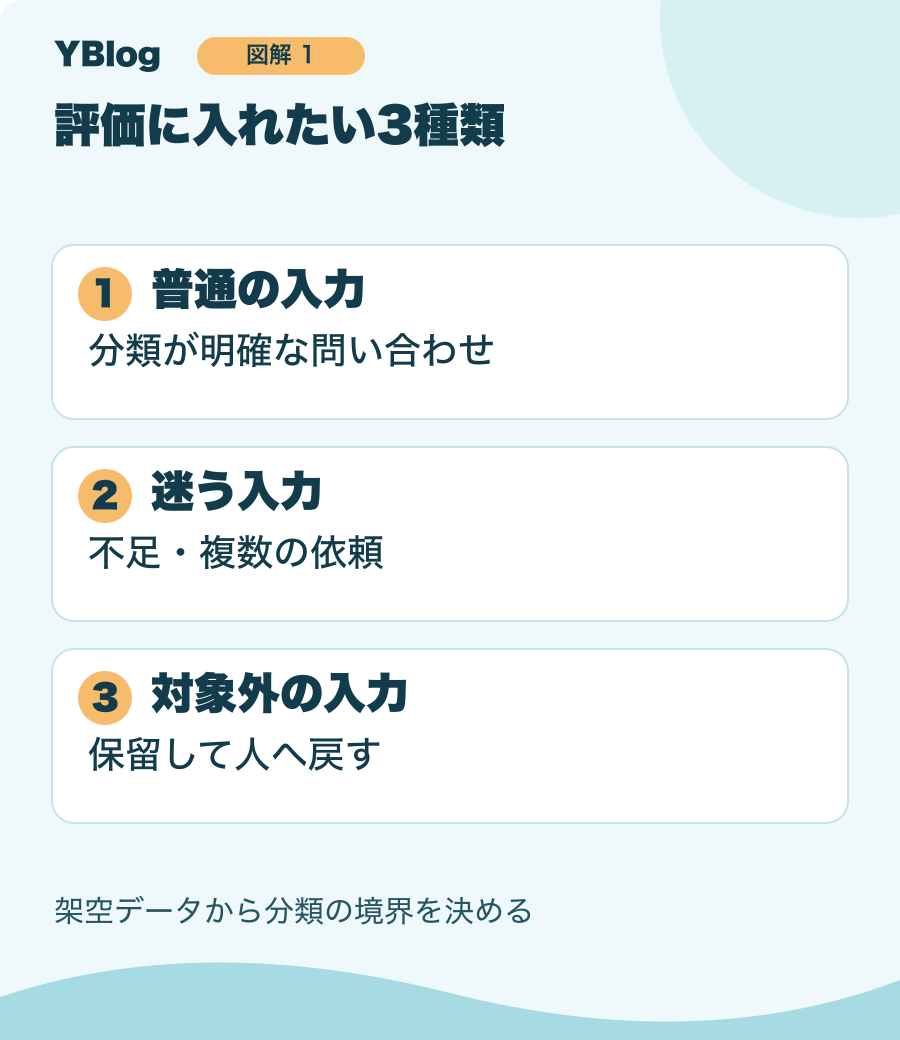
短く明確な文章に加え、誤字、長文、複数の依頼、情報不足、分類外の相談を入れます。実データを使う場合は取扱いを確認し、必要に応じて匿名化します。初期の設計なら架空の文面でも、分類定義が曖昧な点を見つけられます。顧客データをそのまま外部へ送る前提にはしません。
ID:E-004
入力:「ログインできません。ついでにプランも変えたいです」
期待する扱い:判断保留、または複数分類(運用方針で固定)
理由:不具合と契約変更が混在
避けたい結果:一方を捨てて担当へ渡す
確認担当:問い合わせ運用の担当者
正解は担当者同士で確認します。人の判断が割れる例は、AIの性能を比べる前に分類のルールを直す候補です。難しい例を除外して数字だけ上げると、本番で困る場面が評価から消えてしまいます。
集計は「全体」と「判断した分」を分ける
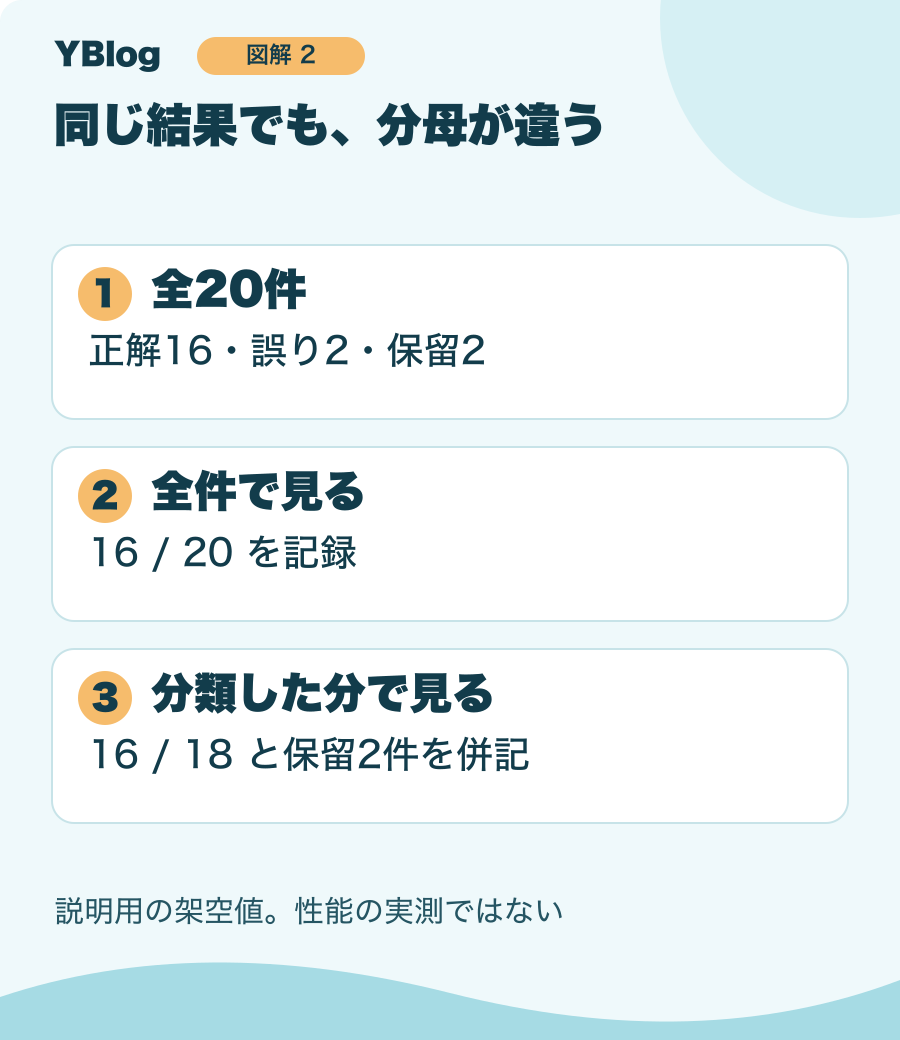
20件中、正解16件、誤り2件、保留2件という架空の結果を考えます。全件に対する正解は16/20。一方、保留を除きAIが分類した18件で見ると16/18です。分母が違うので、同じ「正解率」として並べられません。保留が多すぎれば人の負担が残り、保留を減らしすぎれば誤振り分けが増える可能性があります。
指示を直すデータと、最後に試すデータを分ける
同じ例を見ながら指示を修正すると、その例だけうまく答える形になり得ます。調整用とは別に、最後に評価する入力を取り分けます。モデル、指示文、参照資料、実行日を残し、変える条件を1つずつにすると、何が結果に影響したかを追いやすくなります。
Anthropicの評価設計の解説は、入力・成功条件・繰り返しの試行を分けて扱っています。本稿ではその考えを、問い合わせの振り分けという狭い場面へ応用しました。結果は1回の実行だけで確定させず、揺れる例も記録します。
導入後も、誤りから評価表を育てる
実際に誤振り分けが起きたら、その条件を評価へ追加します。重大な誤りは件数と別に一覧にし、導入を止める条件や人の確認を残す範囲を決めます。最初から自動返信へつなげず、担当候補を示すところから試すと、分類と外部対応の判断を分けられます。
参考資料・確認範囲
2026年11月2日確認。本文の例・図・ひな型は本記事用に作成したものです。以下は、設計や事例の背景として参照した一次資料です。
コメント